Ouvert à un CDI Data Engineer & à des missions freelance

Je construis des pipelines de données fiables.

Je suis Imad, Data Engineer à Paris. Je conçois des pipelines batch & streaming avec Airflow, Spark, Kafka et dbt — de la source brute jusqu’au dashboard — avec la qualité des données intégrée dès la conception.

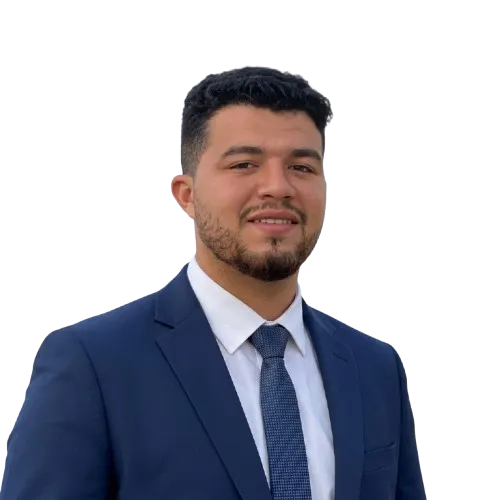
Portrait of Imad Bouzkraoui
SELECT role FROM me;Data Engineer
DAGimad_data_platform@hourly
extract_apiREST · SaaS APIsextract_dbPostgres · Mongoscrape_webPlaywrightingest_rawKafka → S3transformSpark · dbtdq_checksrules + MLload_goldSnowflakeserve_biPower BIserve_mlfeatures · API
run_id: scheduled__…queued
  • 5applications SaaS consolidées dans un pipeline Airflow sur AWS
  • h → mindélai de détection des bugs grâce à un dashboard Power BI × Sentry
  • ~30 fpsde flux vidéo traités en temps réel pour détecter des incidents
  • 100%de Job Success Score en freelance sur Upwork

01À propos

Une donnée fiable est un produit, pas un sous-produit.

Je suis Data Engineer, diplômé d’État en Data Engineering de l’ENSA Al Hoceima. Je termine un Master spécialisé à l’Institut F2I à Paris, en alternance chez VirtuoSys, un éditeur SaaS LegalTech.

Ce qui m’intéresse, c’est la partie moins visible de la data : des pipelines idempotents, monitorés et documentés, pour que les équipes en aval — analystes, produit, métiers — n’aient plus à se demander si les chiffres sont justes. Je l’ai fait pour une banque, un éditeur SaaS et une équipe de vision par ordinateur.

En parallèle, je travaille en freelance sur Upwork — scraping, automatisation et pipelines de données — avec un Job Success de 100 %. Hors clavier : course à pied, musculation, apprentissage du saxophone, et engagement associatif comme ex-Président de l’association SADIM et Vice-Président du Club Data ENSAH.

Basé à
Paris, Île-de-France · Originaire du Maroc
Formation
Master spécialisé en Ingénierie des DonnéesInstitut F2I / DSP · Paris · 2025 — aujourd’huiDiplôme d’Ingénieur d’État, Data EngineeringENSA Al Hoceima · 2020 — 2025
Langues
Français (courant) · Anglais (courant) · Arabe (langue maternelle)
Certifications
IBM · Python for Data Science (2024)IBM · Data Analysis with Python (2023)IBM · SQL and Relational Databases (2023)
whoami.sqlPostgreSQL 16
SELECT name, role, based_in, focus
FROM   engineers
WHERE  pipelines = 'reliable'
  AND  data_quality IS NOT NULL
ORDER BY impact DESC
LIMIT  1;
namerolebased_infocus
Imad BouzkraouiData EngineerParisbatch · stream · DQ

✓ 1 ligne retournée · 0.042 s

02Expérience

Là où j’ai construit des systèmes de données

  1. Déc. 2025 — Aujourd’hui

    Data Engineer · Alternance· VirtuoSys

    SaaS LegalTech · Paris

    • Pipelines Airflow sur AWS (S3, EC2) consolidant logs, données clients et métriques d’usage de 5 applications SaaS hétérogènes.
    • Intégration Power BI ↔ API Sentry : dashboard self-service temps réel (3 pages, 5 projets, ~12 KPIs, RGPD) remplaçant la remontée manuelle des bugs — détection ramenée de plusieurs heures à quelques minutes.
    • Scraping et ingestion de contacts publics LegalTech dans un CRM interne que j’ai conçu ; contribution à un pipeline d’intégration de chatbot.
    • Industrialisation des déploiements via GitLab CI/CD ; pipeline d’automatisation de contenu SEO assisté par IA ; documentation et gouvernance des données.
    AirflowAWS S3AWS EC2PythonSQLPower BISentry APIGitLab CI/CDDocker
    Étude de cas
  2. Fév. — Août 2025

    Data Engineer · Data Quality (stage PFE)· Banque Centrale Populaire

    Data Governance · Casablanca

    • Conception de « Data Watchdog » : passage de contrôles codés en dur à une classification d’anomalies par ML (scikit-learn).
    • Orchestration batch & streaming (Prefect, Kafka), alertes temps réel et boucle de validation humaine où les métiers acceptent ou rejettent les corrections.
    • Gouvernance & sécurité : contrôle d’accès (Apache Ranger), lineage et catalogage (Apache Atlas) ; reporting qualité Power BI (complétude, fraîcheur, anomalies).
    PythonSQLPrefectKafkaPostgreSQLscikit-learnApache RangerApache AtlasPower BIDocker
    Étude de cas
  3. Juin — Août 2024

    Data Engineer · Deep Learning (stage PFA)· Nextronic

    Vidéosurveillance intelligente

    • Pipeline temps réel sur flux caméra live (~30 fps) classifiant 5 types d’incidents (incendie, intrusion…), alerte uniquement sur détection confirmée (persistance 3 s + scoring).
    • Constitution du jeu de données (Kaggle + scraping ciblé par type d’incident) et fine-tuning d’un modèle pré-entraîné Hugging Face.
    PythonOpenCVTensorFlowHugging FaceNumPy
    Étude de cas
  4. 2021 — Aujourd’hui

    Data & Automation Engineer freelance· Upwork

    À distance · clients internationaux

    • Web scraping, automatisation de workflows et pipelines de données pour des clients — avec un Job Success de 100 %.
    • Extraction de données de réseaux sociaux (Instagram, Reddit, LinkedIn), bots autonomes, et jeux de données propres livrés prêts à l’analyse.
    PythonSeleniumPlaywrightBeautifulSouppandas

03Projets choisis

Études de cas

Des pipelines en production et les projets derrière eux — le problème, ce que j’ai construit, et ce que ça a changé.

Production · SaaS LegalTech

Une vue unique sur les données et les bugs de 5 produits SaaS

Des pipelines Airflow sur AWS et un dashboard temps réel Power BI × Sentry qui ont ramené la détection des bugs de plusieurs heures à quelques minutes.

5
applications SaaS consolidées
~12
KPIs en temps réel
h → min
délai de détection des bugs
AirflowAWS S3AWS EC2Python+5
Lire l’étude de cas

Production · Banque

Data Watchdog : une qualité de données qui apprend

Des règles codées en dur à la classification d’anomalies par ML — avec alertes en streaming et boucle de validation humaine — pour l’entité Data Governance d’une banque.

Rules + ML
détection d’anomalies hybride
Batch + stream
Prefect & Kafka
Human-in-the-loop
validation métier
PythonSQLPrefectKafka+6
Lire l’étude de cas

Projet · Analytics engineering

Analytics Airbnb, façon Modern Data Stack

Analytics engineering de bout en bout : S3 → Snowflake → dbt, architecture Medallion, historisation SCD Type 2 et modèles testés.

3
couches Medallion
SCD2
historisation via snapshots dbt
4
types de matérialisation
dbt CoreSnowflakeAWS S3AWS IAM+3
Lire l’étude de cas

Production · Vision par ordinateur

Détection d’incidents en temps réel sur flux vidéo

Des flux caméra à ~30 fps classés en 5 types d’incidents, avec une logique de confirmation pour qu’une image ambiguë ne déclenche jamais d’alarme.

~30 fps
flux en direct
5
types d’incidents
3 s
fenêtre de confirmation
PythonOpenCVTensorFlowHugging Face+1
Lire l’étude de cas

Autres projets

  • DataOps

    CI/CD pour pipelines de données

    Chaque git push est testé, conteneurisé et déployé en DAG Airflow par Jenkins — puis l’exécution est vérifiée dans MongoDB.

    Jenkins · Docker · Airflow · MongoDB · pytest

  • Traitement batch

    Vue client 360 avec PySpark

    Nettoie, croise et consolide une base relationnelle, MongoDB et des événements JSON de livraison en une vue customer_order_360 — avec audit qualité et gestion des rejets.

    PySpark · Spark SQL · PostgreSQL · MongoDB

  • Open data

    RankRace — pipeline de vidéos data-viz

    Un pipeline reproductible qui transforme des séries World Bank et Our World in Data en vidéos animées de type bar chart race, du téléchargement au rendu final.

    Python · pandas · Matplotlib · ffmpeg

  • Web data

    Scraper de profils Instagram

    Extrait et structure le contenu multimédia de profils Instagram sur des pages dynamiques riches en JavaScript.

    Python · Selenium · BeautifulSoup

  • Web data

    Collecte de données Reddit

    Des scripts qui collectent posts et discussions Reddit en jeux de données prêts pour l’analyse.

    Python · Jupyter · pandas

  • Tout le reste est sur GitHubgithub.com/ImadBK01

04Stack technique

La boîte à outils

Des outils utilisés en production ou sur des projets complets — pas une collection de logos.

01Orchestration & traitement

  • Apache Airflow
  • Prefect
  • Apache Kafka
  • Apache Spark (PySpark)
  • dbt
  • Batch & streaming

02Langages

  • Python
  • SQL
  • PL/SQL
  • pandas
  • NumPy
  • Jinja

03Stockage & architecture

  • Snowflake
  • PostgreSQL
  • MongoDB
  • MySQL
  • S3 data lake
  • Lakehouse
  • Medallion

04Cloud & DevOps

  • AWS (S3, EC2, IAM)
  • Docker
  • GitLab CI/CD
  • Jenkins
  • Git
  • Linux

05Qualité & gouvernance

  • Data quality
  • Monitoring & alerting
  • Apache Atlas
  • Apache Ranger
  • Sentry
  • GDPR

06BI, ML & scraping

  • Power BI (DAX)
  • scikit-learn
  • Hugging Face
  • OpenCV
  • LLM / RAG
  • Selenium
  • Playwright

05Freelance

Besoin d’un data engineer pour une mission ?

En parallèle de mon poste de data engineer, je prends un petit nombre de missions freelance — via Upwork ou en contrat direct. Les mêmes standards qu’en production : testé, documenté, monitoré.

  • Pipelines & orchestration

    Des pipelines batch ou streaming depuis vos API, bases et fichiers vers un stockage propre et requêtable — planifiés, relancés et monitorés.

    Airflow · Prefect · Kafka · Spark

  • Entrepôt & Modern Data Stack

    Un entrepôt fiable pour vos analystes : couches Medallion, modèles dbt testés, historisation et documentation.

    dbt · Snowflake · PostgreSQL · AWS

  • Extraction web & automatisation

    Des scrapers et bots robustes qui tournent seuls et livrent des données propres et dédoublonnées — ou suppriment une tâche manuelle pour de bon.

    Python · Selenium · Playwright

  • Dashboards & qualité des données

    Des dashboards Power BI sur des données monitorées, avec contrôles et alertes qui arrêtent la donnée fausse avant qu’elle n’arrive dans une décision.

    Power BI · Sentry · dbt tests

Déroulé d’une mission

  1. 01Appel découverte30 minutes, gratuit : vos données, votre objectif, vos contraintes.
  2. 02Proposition cadréeLivrables, planning et prix clairs — au forfait ou à l’heure.
  3. 03Développement transparentAccès au dépôt dès le premier jour et démos régulières.
  4. 04PassationDocumentation, runbook et démonstration pour que votre équipe soit autonome.

07Contact

Construisons quelque chose de fiable.

Vous recrutez un data engineer, ou vous avez besoin d’aide sur un pipeline, un entrepôt de données ou un projet de scraping ? Écrivez-moi par email ou sur WhatsApp — je réponds sous 48 heures.

Ouvert à un CDI Data Engineer & à des missions freelance

Discuter sur WhatsApp